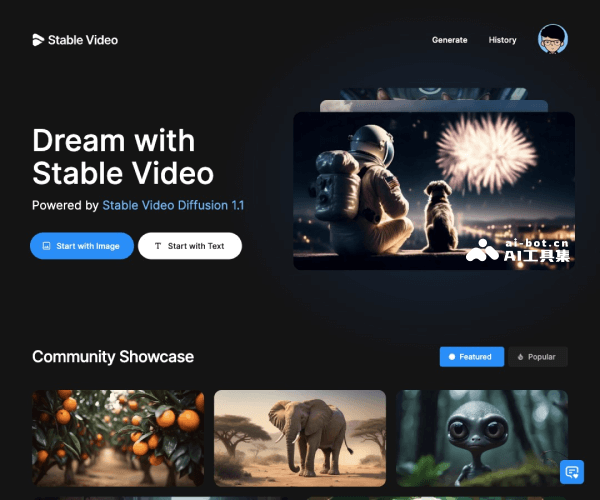
Stable Video 是由 Stability AI 推出的生成式视频模型,全称为 Stable Video Diffusion,基于 Stable Diffusion 图像生成架构扩展而来。该模型旨在将文本提示直接转换为高质量的视频输出,为创作者、开发者和企业提供从静态生成到动态叙事的完整能力。作为开源生成式 AI 生态的一部分,Stable Video 强调可访问性与适应性,支持在自有的基础设施上进行部署和深度定制。
核心能力方面,Stable Video Diffusion 支持 Text-to-Video 任务,用户仅需输入自然语言文本提示即可生成对应的视频片段。模型能够生成 14 帧和 25帧两种长度的视频,并允许在每秒 3 至 30 帧之间自定义帧率,从而适配不同场景对视频流畅度和时长的需求。在性能上,该模型可在 2 分钟或更短时间内完成视频生成,适合快速迭代创作流程。此外,Stable Video 提供自托管许可证(Self-Hosted License),允许企业将模型部署在自有环境中,实现高级定制与数据隐私控制。
Stable Video 的模型架构延续了 Stable Diffusion 的扩散模型路线,通过潜在空间中的去噪过程生成视频帧序列。它既可独立用于文本驱动的视频创作,也可作为视频编辑、动画生成、概念预览等工作的基础模型。结合 Stability AI 提供的平台 API、云平台集成与社区许可证,开发者能够将视频生成能力嵌入到更复杂的应用管道中,实现从图像到视频、从文本到动态内容的自动化生产。
该产品适用于广告创意、影视预演、社交媒体内容生产、游戏资产开发、产品演示和教育培训等多种场景。通过自托管部署,企业可以确保数据安全并针对垂直领域进行微调,从而打造专属的视频生成解决方案。Stability AI 持续推动开放模型的前沿发展,Stable Video 是其多模态生成矩阵中的重要组成部分。
Stability AI是英国开源生成式AI公司,2020年成立于伦敦,主营开源图像、音频与视频生成模型。其开源模型Stable Diffusion引发文生图革…
查看公司主页