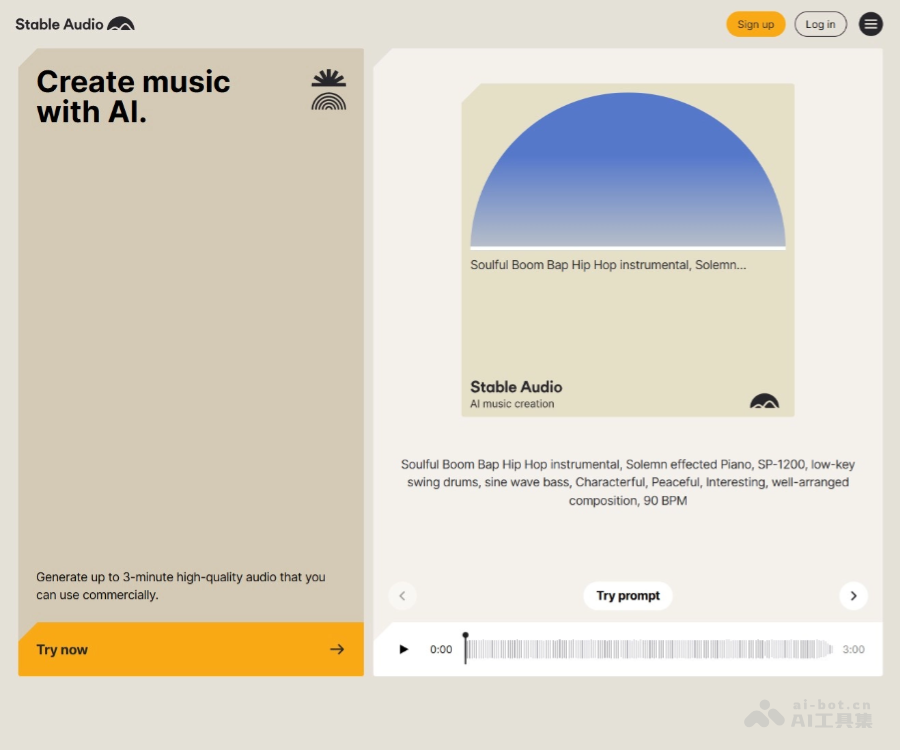
Stable Audio 是由 Stability AI 推出的 AI 音乐与声音生成工具,旨在通过先进的生成式 AI 技术,帮助用户从文本描述或已有音频出发,创建从短循环片段到最长 6 分钟完整曲目的高质量音频内容。作为一款面向专业音频创作者的工具,Stable Audio 结合了自然语言控制与精细化的音频编辑能力,让音乐制作、声音设计与音效生成变得更加高效、直观。
在核心能力层面,Stable Audio 支持全混音多轨生成,可根据用户设定的时长模式(0:30 循环、1:00 短片、1:30 歌曲、3:00 加长等)输出结构完整的音频作品。其对话式控制界面允许用户通过自然语言指令生成音乐和声音效果,并借助音频到音频(audio-to-audio)与局部重绘(inpainting)技术,对生成的音频进行局部替换和迭代优化,而无需整轨重新生成。此外,Stable Audio 还提供实验性的分轨(stems)生成与导出功能,方便用户在 DAW 中进一步混音处理。
Stable Audio 提供三种产品形态:浏览器 Web 应用、DAW 插件(支持 Ableton、Logic、Pro Tools 等主流宿主)以及 API 平台。DAW 插件让创作者无需离开熟悉的制作环境即可调用 Stable Audio 3.0 的生成能力;API 平台则提供全托管、可扩展、低延迟的推理服务,支持按次计费与批量折扣,并为企业用户提供定制化部署与白手套实施支持。社区案例还展示了通过自定义 LoRA 微调与 ONNX 本地推理等高级扩展用法。
Stable Audio 的价值在于将 AI 生成从“一次性产出”转变为“可持续迭代的创作流程”。无论是生成音乐动机、设计声音景观、制作配乐,还是构建个人采样库,用户都可以从任意起点出发,不断探索、编辑与优化,直至音频真正符合个人风格。凭借专业级的功能设计与活跃的艺术家社区,Stable Audio 正在与音乐人和技术人员共同推动 AI 音频创作的未来。
Stability AI是英国开源生成式AI公司,2020年成立于伦敦,主营开源图像、音频与视频生成模型。其开源模型Stable Diffusion引发文生图革…
查看公司主页