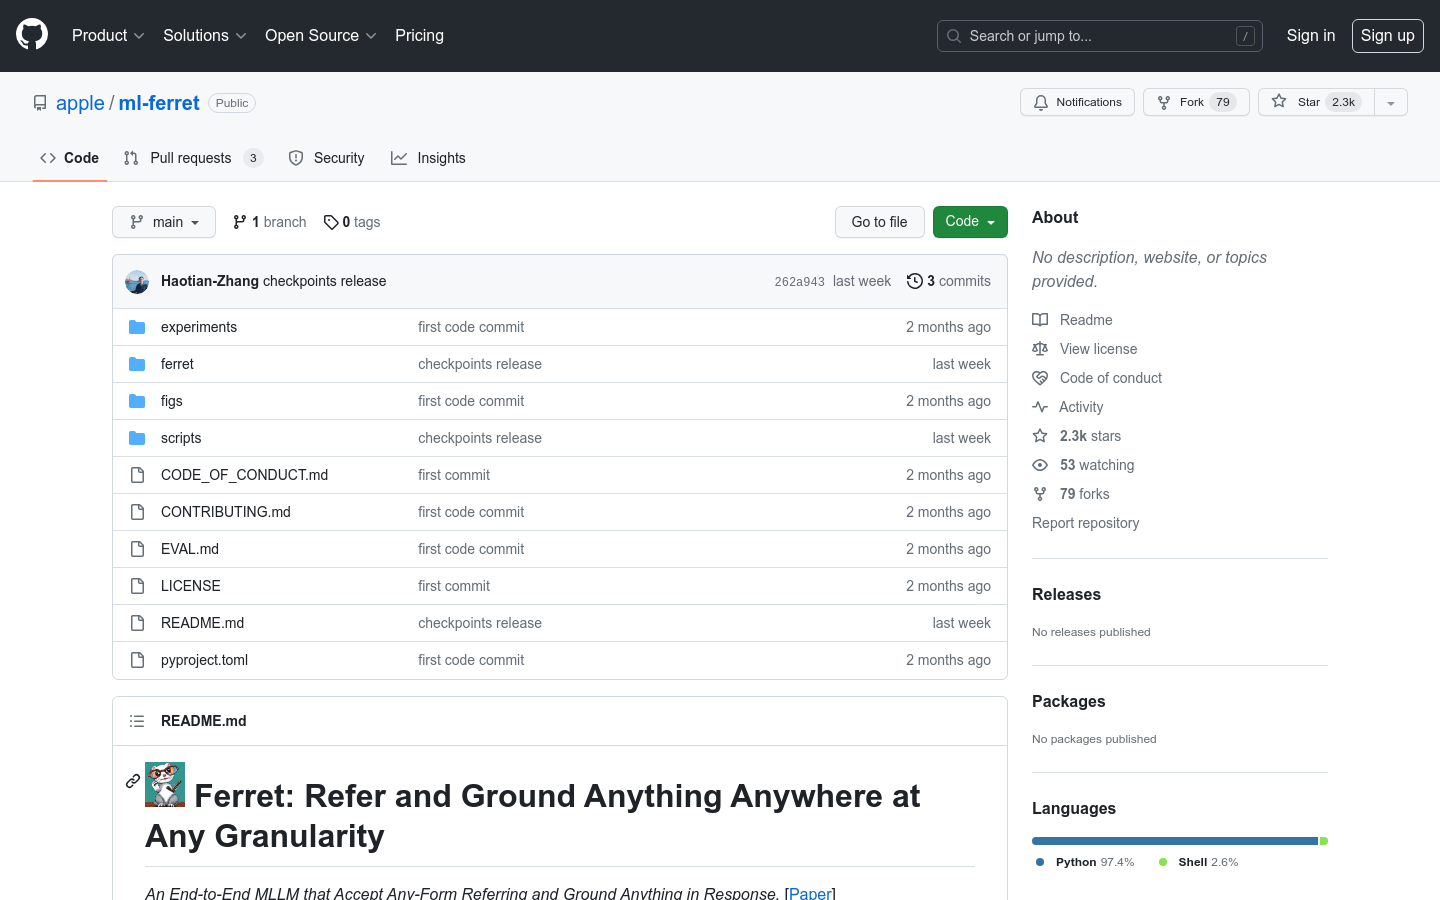
Ferret 是一款由苹果团队研发的端到端多模态大语言模型(MLLM),能够接受任意形式的空间指代(如点、框、草图)并精准定位图像中任意粒度的物体,同时生成丰富的语义描述。该模型创新性地提出了混合区域表示与空间感知视觉采样器,首次实现了开放词汇的指代与定位能力。
Ferret 基于 LLaVA 框架构建,融合了 Vicuna 语言模型与 CLIP 视觉编码器,并通过大规模层次化指令微调数据集 GRIT(约110万样本)进行训练。模型支持 7B 和 13B 两个参数量版本,可在 8 张 A100 GPU 上完成训练,并提供了公开的权重差分文件,便于研究社区复现和使用。
项目还配套发布了 Ferret-Bench 多模态评估基准,专门测试模型在指代、定位、语义理解、知识推理等联合任务上的表现。Ferret 的研究成果已被 ICLR 2024 接收为 Spotlight 论文,后续衍生版本 Ferret-v2 和 Ferret-UI 进一步拓展了在 UI 理解等垂直场景的应用。
输入文字或图片,AI即刻生成流畅视频与精美图片,让灵感瞬间成真
用AI释放你的创意潜能,一键生成惊艳图像与视频特效

释放无限创意,用文字或图片一键生成高清视频,让想象跃然眼前
阿里云自研人工智能绘画大模型,支持文字生图、相似图生成与风格迁移,把想象力变成现实

用自然语言驱动AI智能体,在无限画布上从零打造专业级动漫短剧,让每个人都能成为漫剧导演
扣子Coze是字节跳动旗下的一站式AI开发平台与职场AI伙伴,让用户以自然语言驱动Agent完成从编程到内容创作的复杂任务。